
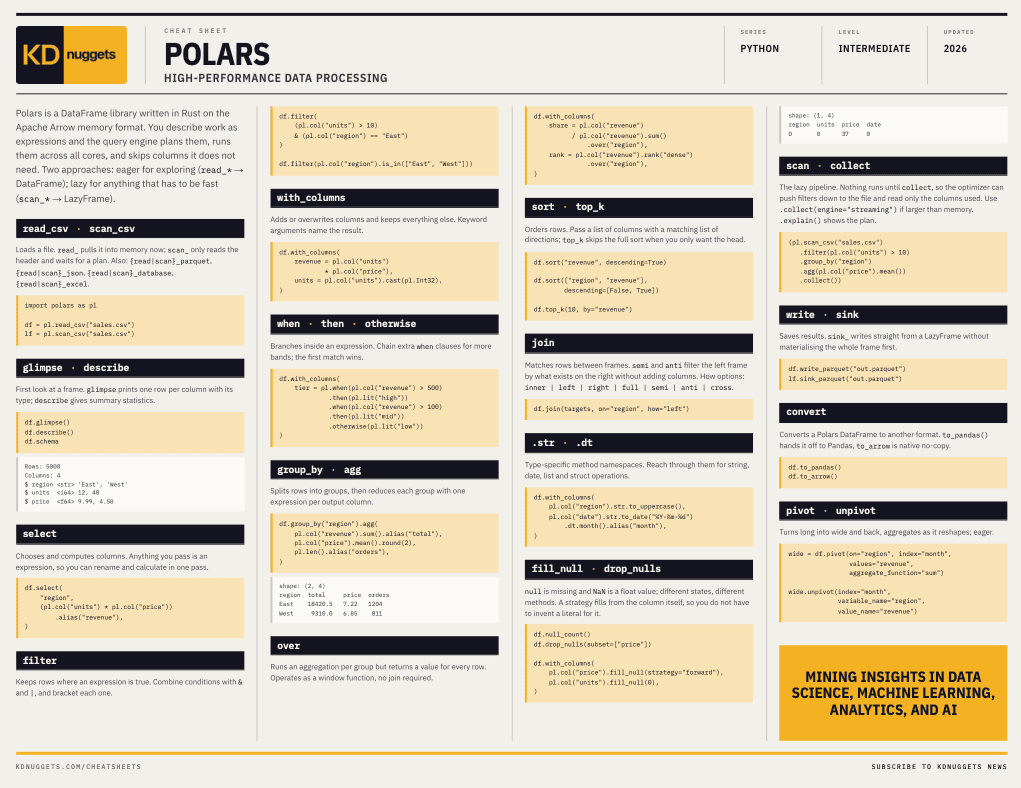
一份 CSV 明明放得下硬盘,处理时却塞不进内存;电脑有十几个核心,任务还只占一个。KDnuggets 的这份速查表解释了 Polars 为什么能缓解这些问题:它是处理 DataFrame(带列名和类型的二维数据表)的工具,但速度优势不只是因为用 Rust 编写,更来自整套执行方式。
关键在 scan_csv 和 collect。前者先读取文件头,不立刻把整份数据装进内存;其后的筛选、计算都先记成表达式,直到 collect 才真正执行。这种“惰性执行”让查询优化器先看完整流程,把筛选提前到读文件阶段,并跳过用不到的列。底层的 Apache Arrow 又把同一列数据紧密排列,便于批量计算和减少转换。Polars 还能调用多个 CPU 核心;文件大于内存时,collect(engine="streaming") 可分块处理。换句话说,它像先看完整张采购单,再只搬需要的箱子,而不是把仓库全部清空后慢慢挑。文章是一份用法速查表,并未提供统一的性能测试数字。