
在医院找诊室时,你通常只想迅速看清箭头和房间名。但同一行字,对视物模糊、中央视野缺失和周边视野缺失的人,未必同样好认。把字号放大并不能解决一切;字母太挤、内部空间太小,也会让辨认变难。
Typotheque 的 Zed 正是从这里切入。它最初要回答一个排版问题:一套无衬线字体,能否同时做好密集正文和醒目标题?后来,巴黎 Quinze-Vingts National Ophthalmology Hospital 的导视项目把它推向低视力测试。到 2026 年,Zed 已成为一个包含两种光学版本、四条可变轴和九种文字系统的庞大家族。所谓“一套字体做出500种样式”,准确说是每个相应语言版本提供 558 个预设静态样式;可变字体还能生成这些预设之间的中间状态。
正文和标题,不该只是同一张图缩放
Zed 分为 Zed Text 和 Zed Display。两者属于同一字体家族——共享基本骨架,又能在字重、宽度和风格上变化——但采用不同的光学版本。
“光学版本”不是自动调字号,而是针对使用尺度重新设计细节。小字号正文需要更开阔的字母内部空间、更明确的字符差异和更结实的细笔画;大字号标题则可以更紧凑、更精细。供稿材料将两者概括为:Zed Text 使用较开放、偏人文主义的形态,Zed Display 则采用更紧凑的几何 neo-grotesque 比例。
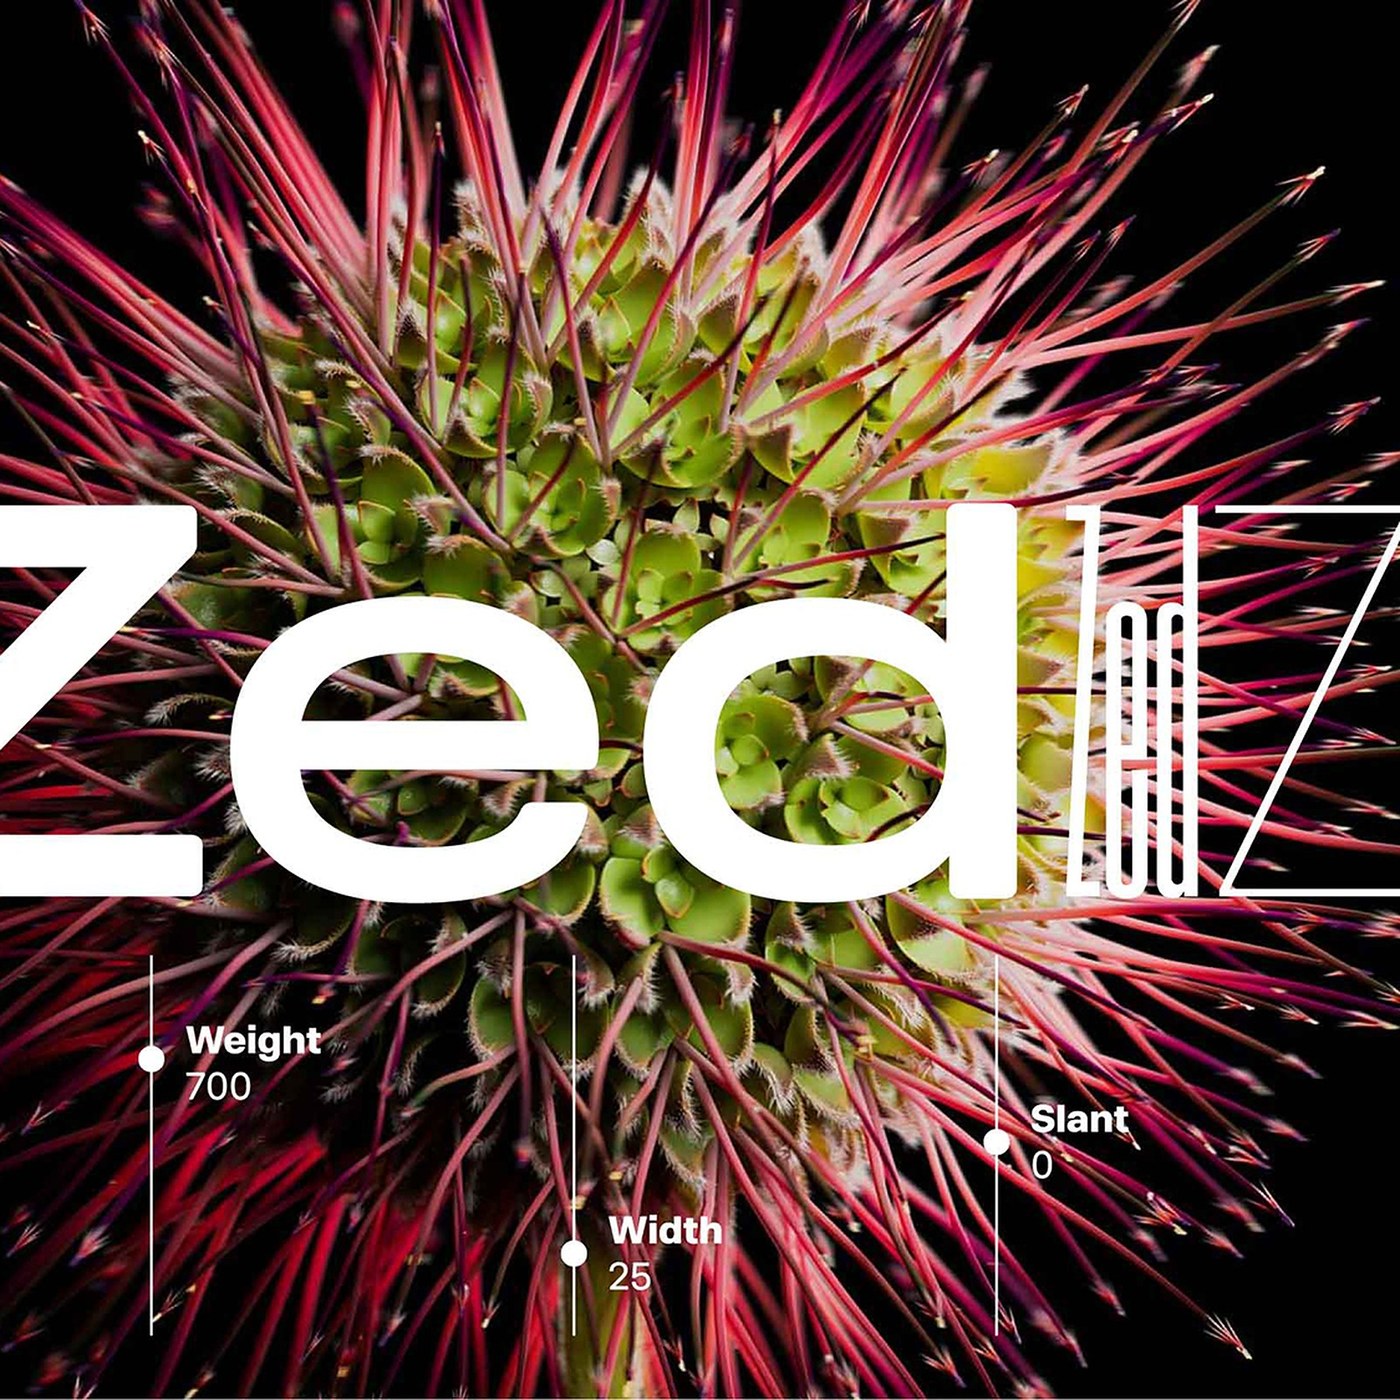
Zed 还提供 Weight(字重)、Width(字宽)、Slant(倾斜度)和 Roundness(圆润度)四条可变设计轴。可以把它们理解成四个连续旋钮:设计师不必只在“粗体”和“细体”之间二选一,而能按正文、标题或导视距离逐项调整。其在线可视化工具由设计师兼程序员 Just van Rossum 参与开发。
没有一种比例适合所有眼睛
Zed 真正值得注意的地方,不是样式多,而是团队把字宽选择带进了低视力实验。
实验在 Quinze-Vingts 国家眼科医院进行,这套字体也用于医院导视。研究说明记载,正式实验有 55 名参与者,每人完成 120 次特定距离下的字母识别任务,共 6600 次。参与者包括视物模糊、中央视野缺失、周边视野缺失和正常视力对照组。不过这组人数与项目宣传材料中的“57人、6840次测量”存在口径冲突,可能混入了不同实验阶段,因此本文采用研究说明的数字。
结果没有给出一个包打天下的“最佳字宽”。公开结果显示,周边视野缺失组与中央视野缺失组表现较好的版本都是 width 140;视物模糊组和正常视力组则是更宽的 width 160。这里的 140 只是相对 160 较窄,不能简化成“隧道视野适合窄体字”。
更反直觉的是,较宽字形也改善了正常视力对照组在这项任务中的识别表现。研究团队认为,这可能与减轻字符拥挤有关:字母结构拉开后,相邻笔画不那么容易在视觉上挤成一团。前导研究中,Helvetica 在各患者组的表现显著差于受测的 Zed Text 版本,因此没有进入主实验;这一结论来自单一研究来源,也只适用于当时的测试设置。
这启发了一种“被动适配”的导视思路:不同楼层或诊区可以悄悄采用不同字宽,不要求使用者先声明自己的视觉状况,也不假定所有人需要同一种比例。
从视觉差异,走向文字差异
Zed 于 2024 年首次发布,2026 年又经过扩展与重新工程化。截至 2026 年初,官方明确列出的支持范围包括 Latin、Armenian、Chinese、Cyrillic、Georgian、Greek、Hebrew、Japanese 和 Korean,并计划继续增加约 17 至 20 种文字系统。
多文字系统字体的难点,不是把不同文字强行画得一样。它需要尊重各自的书写传统,同时让它们在同一产品里保持相近的视觉层级和阅读节奏。Typotheque 还与原住民社群合作,为缺失字符提出 Unicode 编码方案;据其项目材料,相关字符已被纳入 Unicode 16.0。
这让 Zed 的系统野心变得清楚:它同时处理正文与标题、不同视觉状况,以及不同书写系统之间的协调。558 个样式只是结果,真正的设计对象是差异本身。
局限与未知
- 现有实验测的是特定距离下的字母识别,不能直接扩大为连续阅读速度或所有场景中的普遍可读性。
- 不同来源对参与人数和测量次数的说法不一;55 人、6600 次是研究说明的口径。
- Arabic、Cherokee、Canadian Syllabics、Braille 等曾出现在项目介绍或路线图中,但截至 2026 年初,不能把它们全部算作已经发布的 Zed 文字系统。