
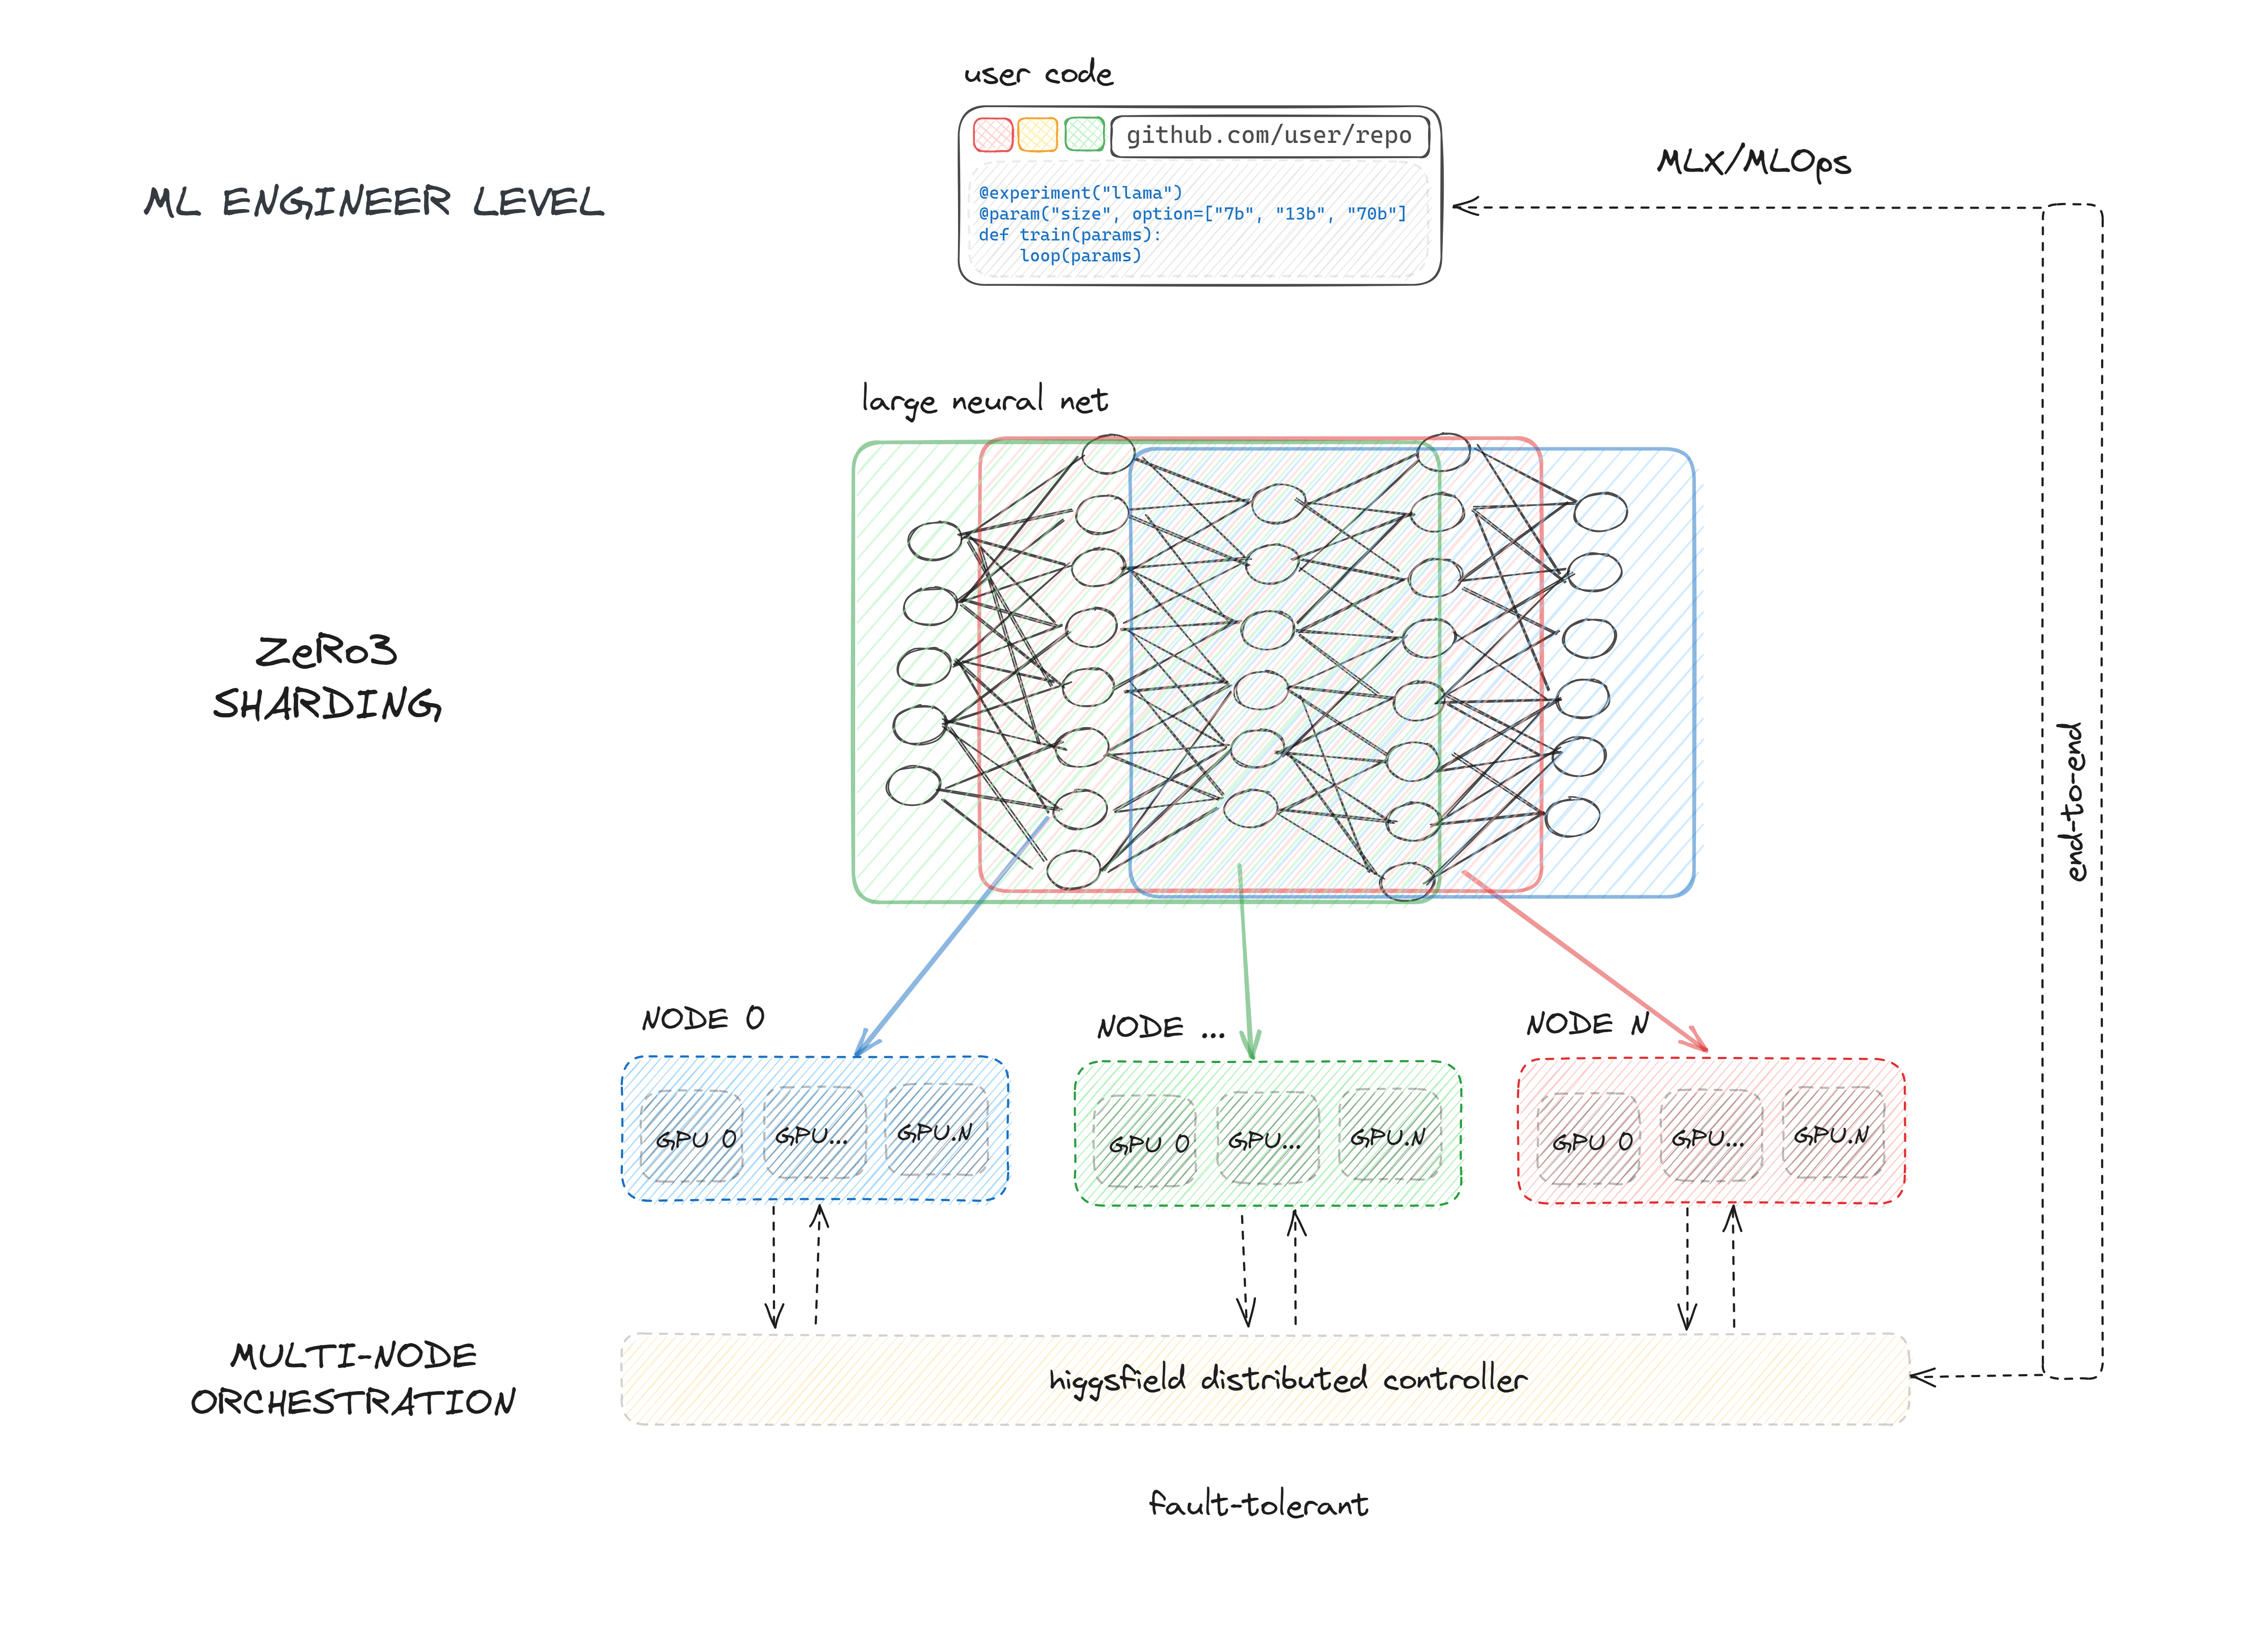
训练超大模型,像让一支车队连续跑上几天:既要给每辆车安排路线,也要防止其中一辆抛锚后全队重来。Higgsfield 做的正是这层管理工作。它是一套开源 GPU 编排与机器学习框架,负责在多台机器间分配计算资源、排队运行实验,并让训练在故障后继续。项目单日新增 196 星,说明开发者的注意力又回到这类基础设施上。
它面向数十亿到数万亿参数的模型,支持 ZeRO-3 和 PyTorch FSDP——两者都会把模型权重、梯度等拆到多块 GPU 上,减轻单卡显存压力。Higgsfield 还沿用常见的 PyTorch 训练写法,并可接入 GitHub 与 GitHub Actions,自动把代码部署到训练节点、启动实验和保存检查点。项目材料称其已在 Azure、LambdaLabs 和 FluidStack 测试;除这些能力说明外,材料未提供性能对比或大规模运行数据。