
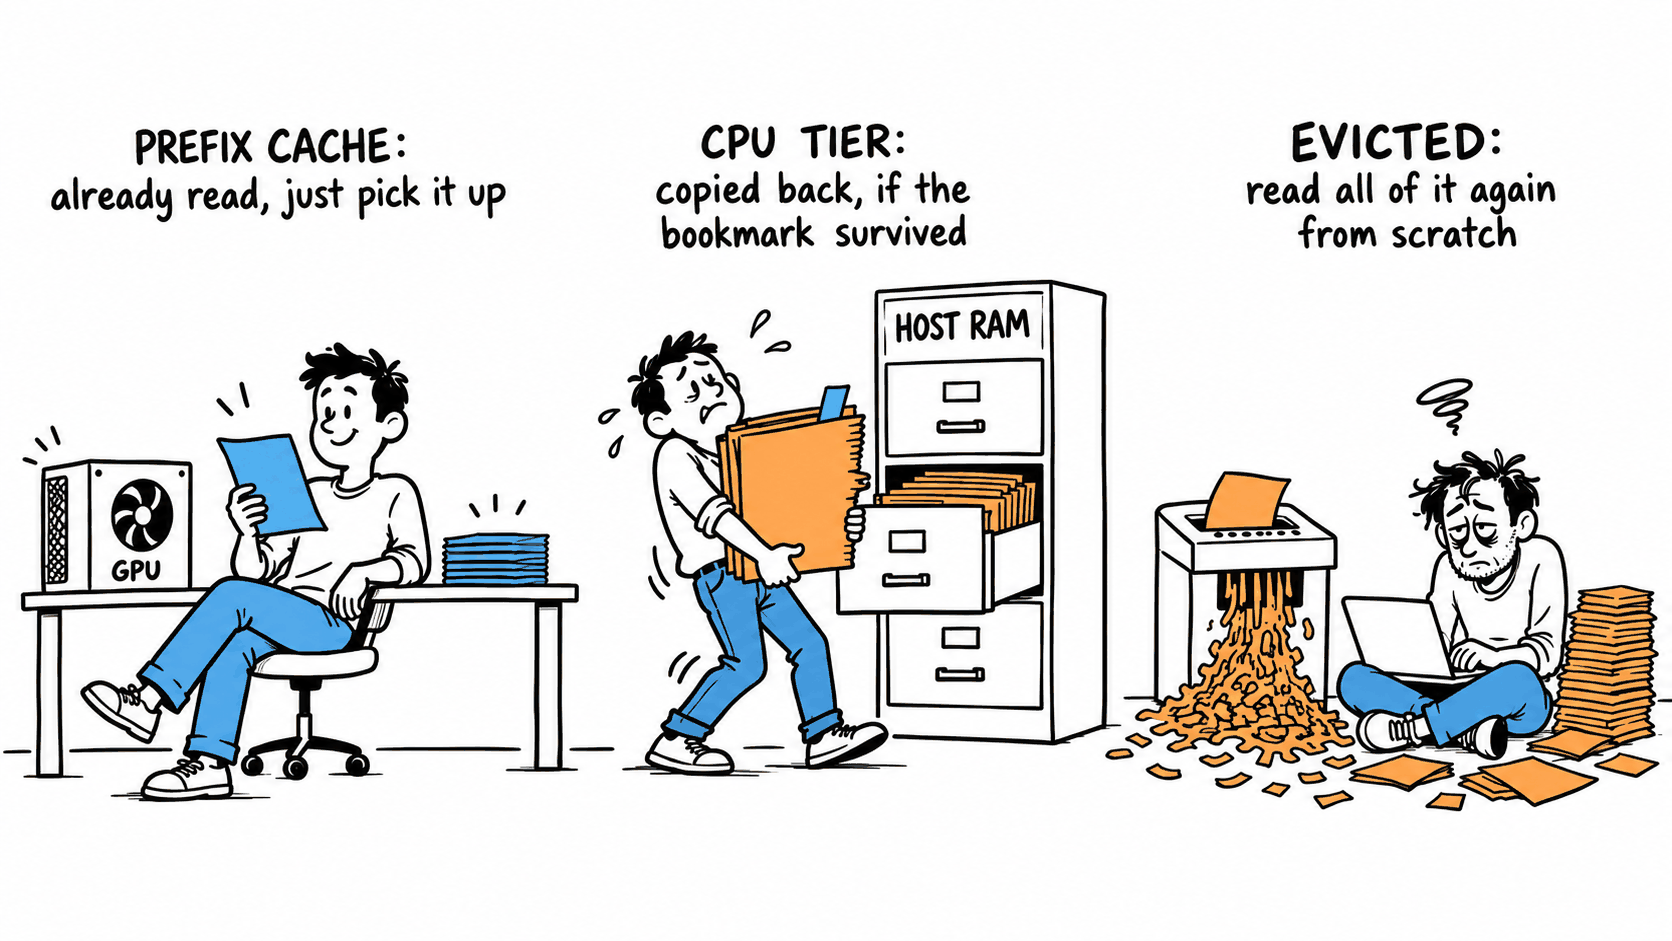
让 AI 编程助手连续干活,像每聊一句都要它重读整本工作日志:对话越长,第一句话等得越久。作者用两张 RTX 3090 在 vLLM——负责运行大模型的开源推理引擎——上部署 Qwen3.8-27B,尝试让 Agent 在不同轮次间保留前缀缓存,也就是复用系统指令、工具说明和旧消息的中间计算结果。
作者称,调整后由缓存提供的提示词比例从 55% 升至 95%,首字平均等待从 26—28 秒降至 7.3 秒,最慢一次则从 514 秒降至 54 秒。一个 12 万 token 的请求若从头读取约需 150 秒;缓存仍在时,只需处理新增的约 2000 token,约 3 秒即可开始回答。关键限制是缓存只能从开头连续匹配:若第 1.2 万个 token 发生变化,后面 10.8 万个 token 的结果都无法复用。
这些数字不能只归功于缓存:作者同时合并了两张显卡、调整批处理预算,并启用了推测解码和 CPU 卸载。它更像一份部署实录,但清楚指出了多轮 Agent 的成本盲点:模型未必在“思考”,也可能只是在反复重读。